ADsP(데이터분석 준전문가) 제1과목 ‘데이터의 이해’의 두 번째 단원인 PART 2 데이터의 가치와 미래를 시작합니다. 이번 파트에서는 전통적인 정형 데이터 관리 체계를 넘어 전 세계적으로 폭증하는 대규모 데이터를 다루는 ‘빅데이터’의 본질과 패러다임 변화를 다룹니다.
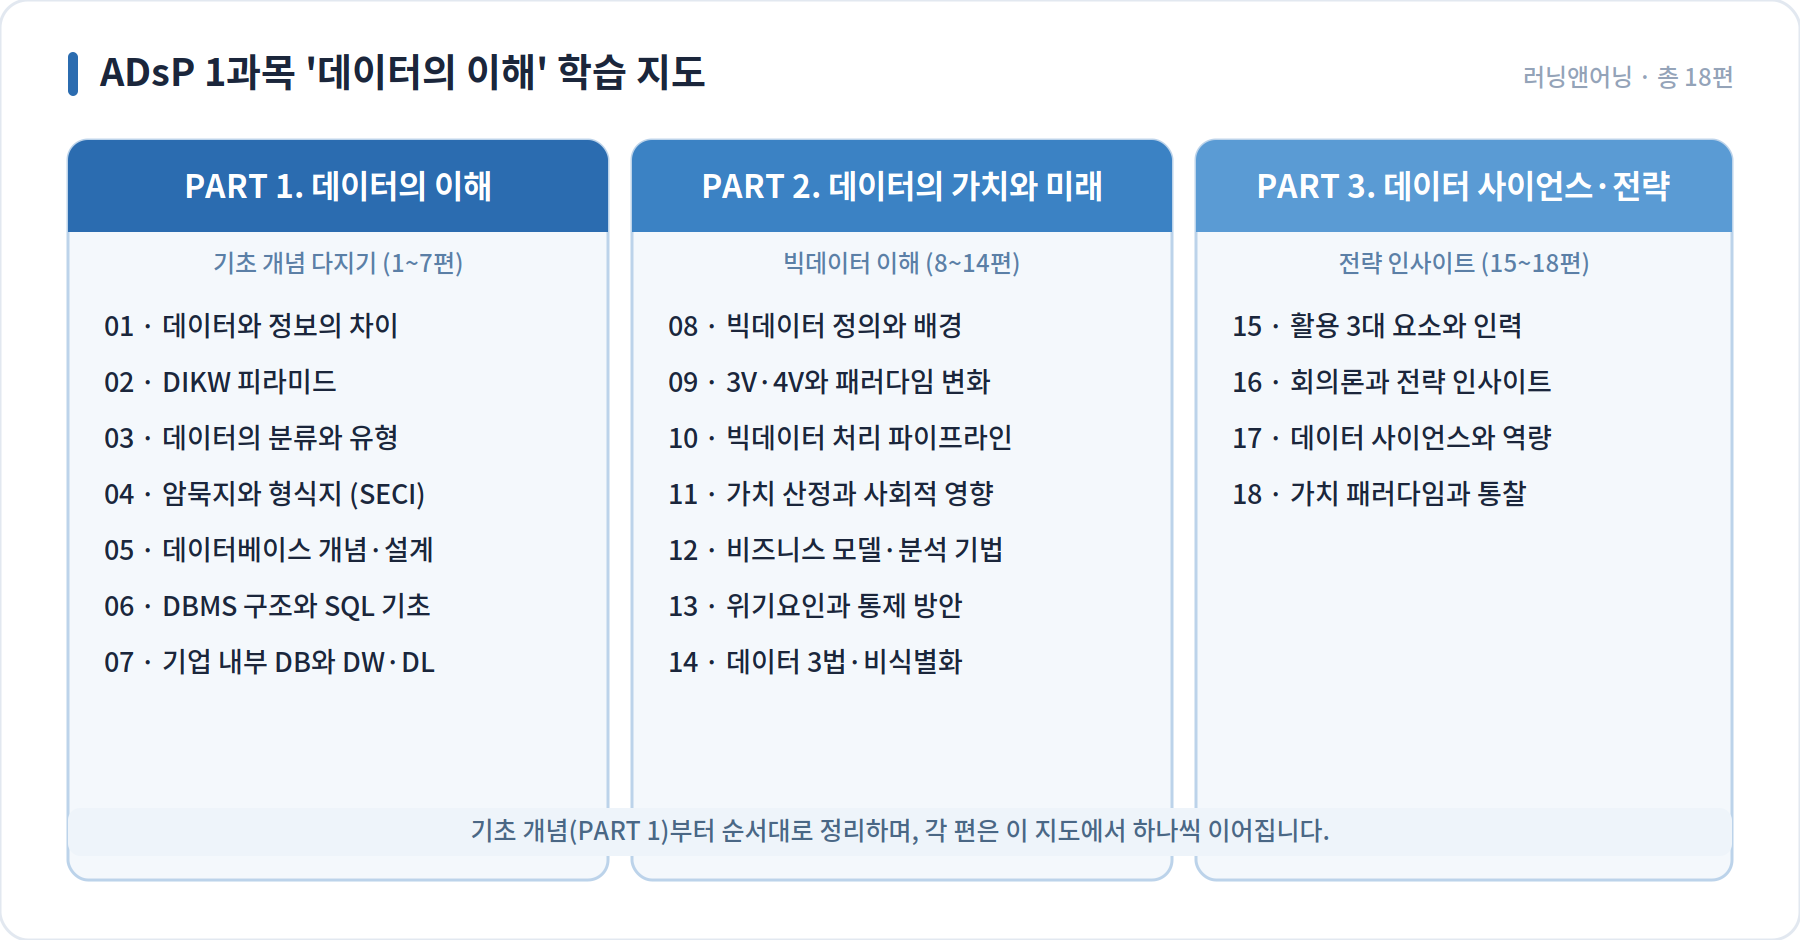
쏠티북스의 『선넘는 ADsP』 교재를 바탕으로, 비전공자도 직관적으로 이해할 수 있도록 초대형 제련 콤비나트 공장과 대용량 계량 체계에 빗대어 빅데이터의 정의, 출현을 이끈 핵심 기술(클라우드·분산처리), 데이터 용량 단위(PB~YB), 그리고 데이터 산업 발전 흐름 5단계를 차근차근 정리해 보겠습니다. 1과목 전체 학습 순서는 ADsP 1과목 독학 지도에서 확인할 수 있습니다.
1. 빅데이터(Big Data)란 무엇인가: 기존 설비의 한계를 넘은 원자재의 범람
빅데이터(Big Data)는 단순히 저장 공간을 많이 차지하는 대용량 데이터만을 의미하지 않습니다. 기존의 관계형 데이터베이스 관리도구(RDBMS)로는 수집, 저장, 관리, 분석하기 어려운 거대한 크기와 다양한 형태(비정형 포함)를 지닌 데이터 집합을 포괄하는 개념입니다.
초기에는 ‘데이터의 양(Volume)이 크다’는 점에 주목했으나, 점차 정형·비정형을 아우르는 다양성(Variety), 초고속 생성·처리를 뜻하는 속도(Velocity), 그리고 이를 통한 가치(Value) 창출과 활용성까지 확장되어 정의되고 있습니다.
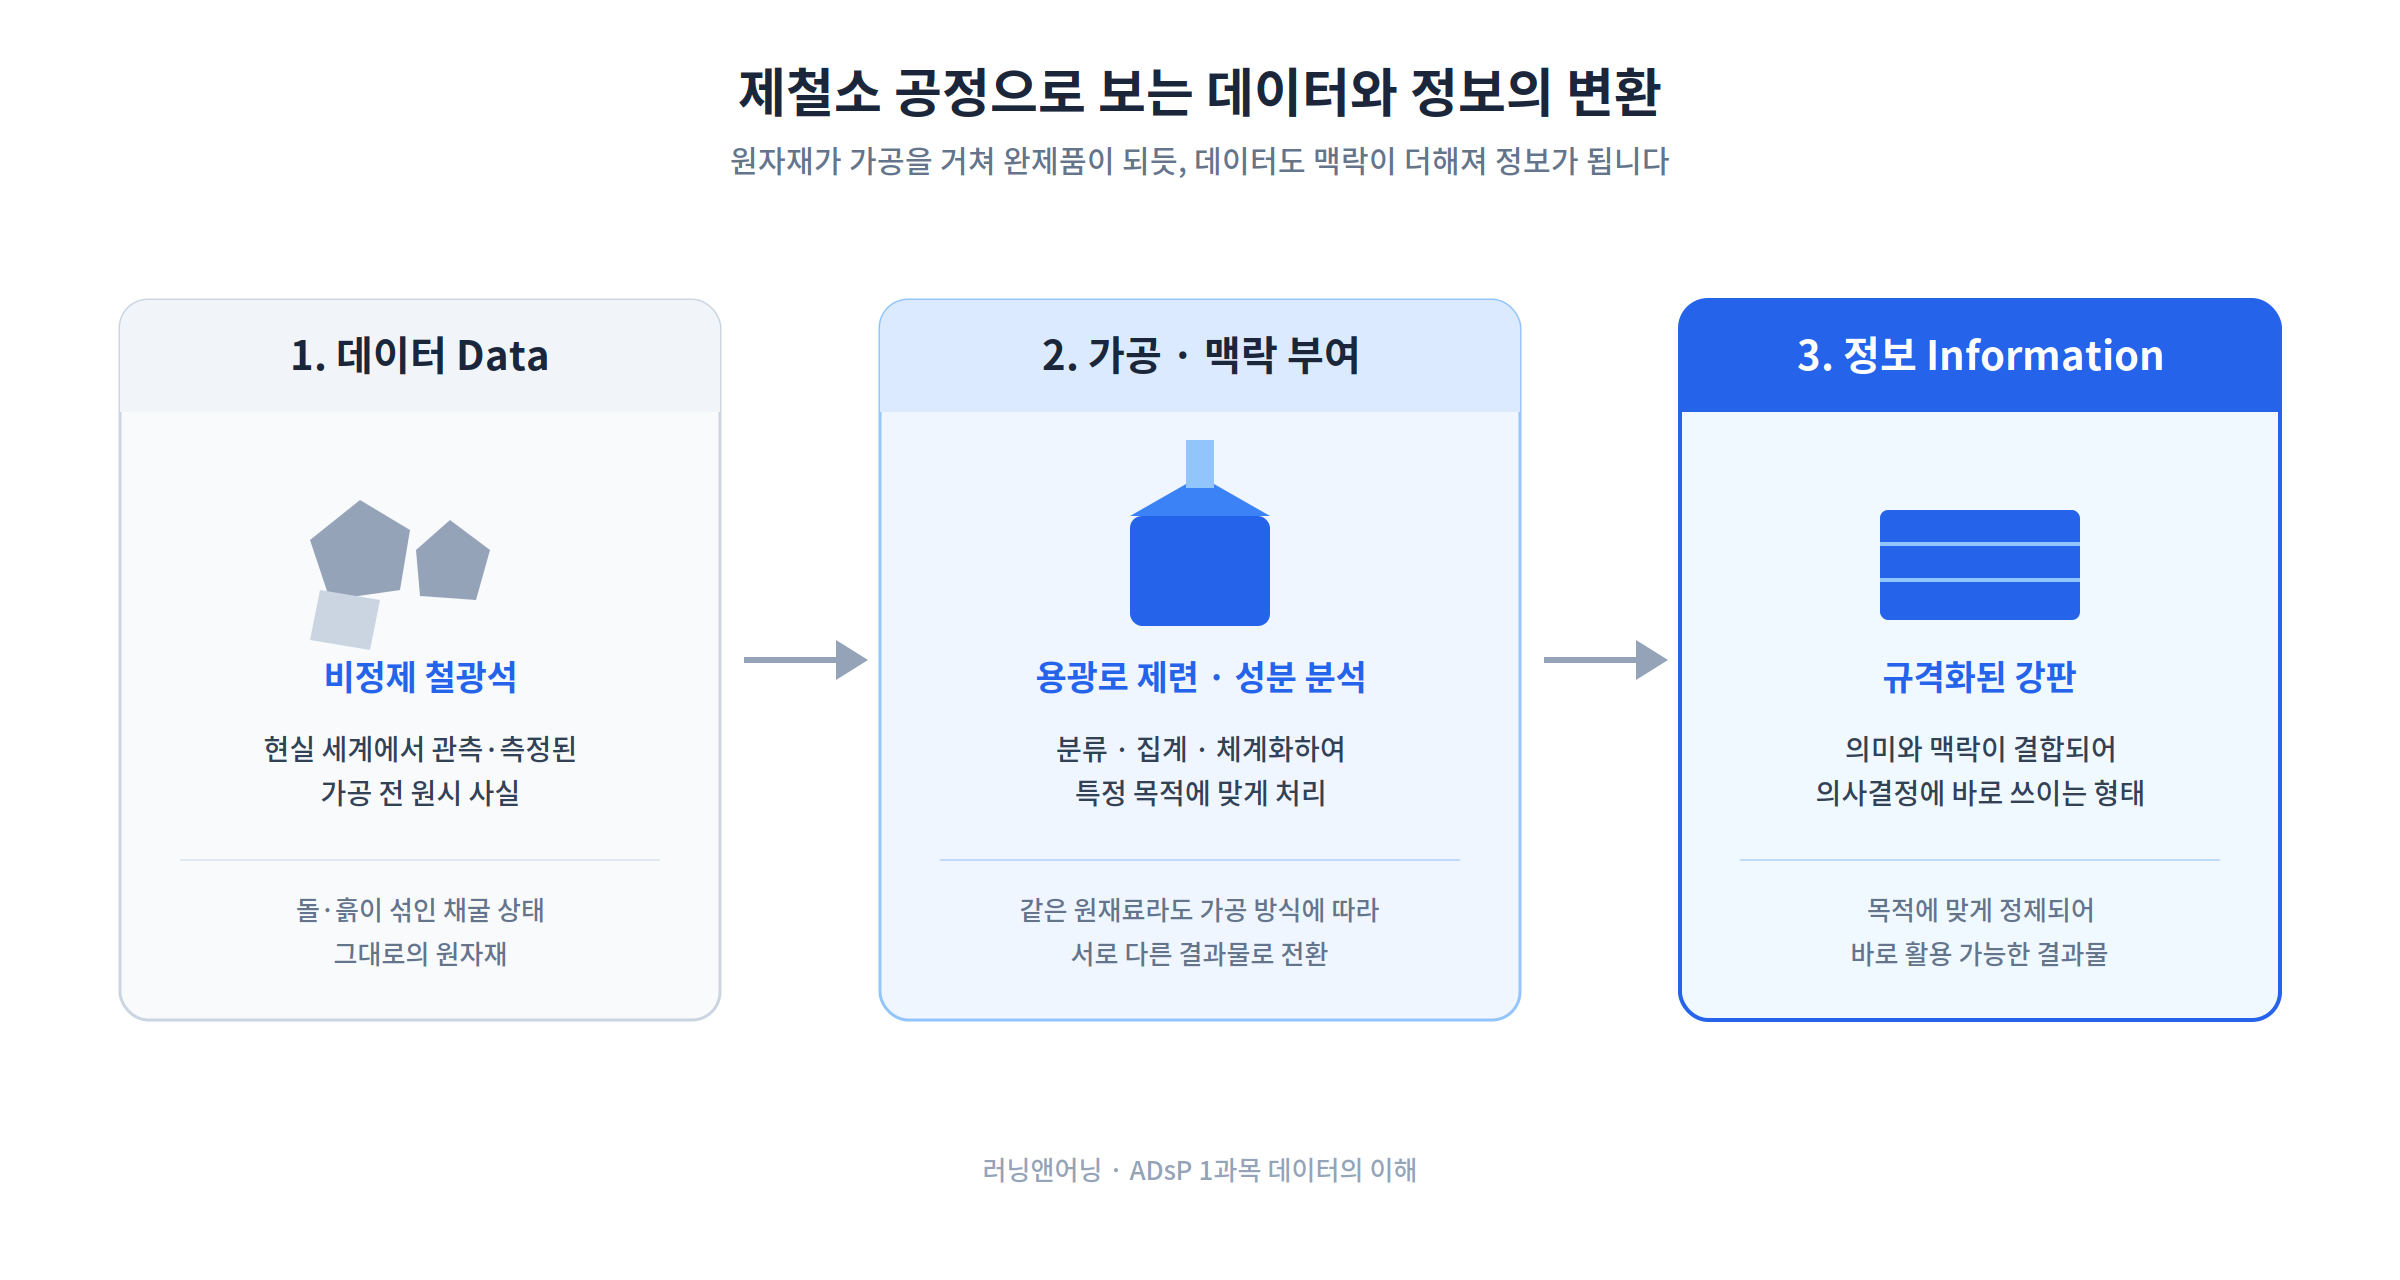
이를 제련 제조 산업의 변화에 비유하면 다음과 같습니다.
- 기존 데이터 환경: 규격화된 소량의 철광석만 다루던 ‘소형 단일 제련소’입니다. 표준 규격 틀(RDBMS 스키마)에 맞춰 들어오는 원석만 처리할 수 있었습니다.
- 빅데이터 환경: 전 세계 광산과 재활용 현장에서 수만 톤의 원석, 자갈, 비규격 혼합 광물(정형·반정형·비정형)이 초고속으로 쏟아져 들어오는 ‘초대형 복합 제련 콤비나트’입니다. 기존 단일 용광로로는 감당할 수 없어 완전히 새로운 분산 처리 및 자동화 저장 기술이 요구됩니다.
2. 빅데이터의 출현 배경과 핵심 견인 기술
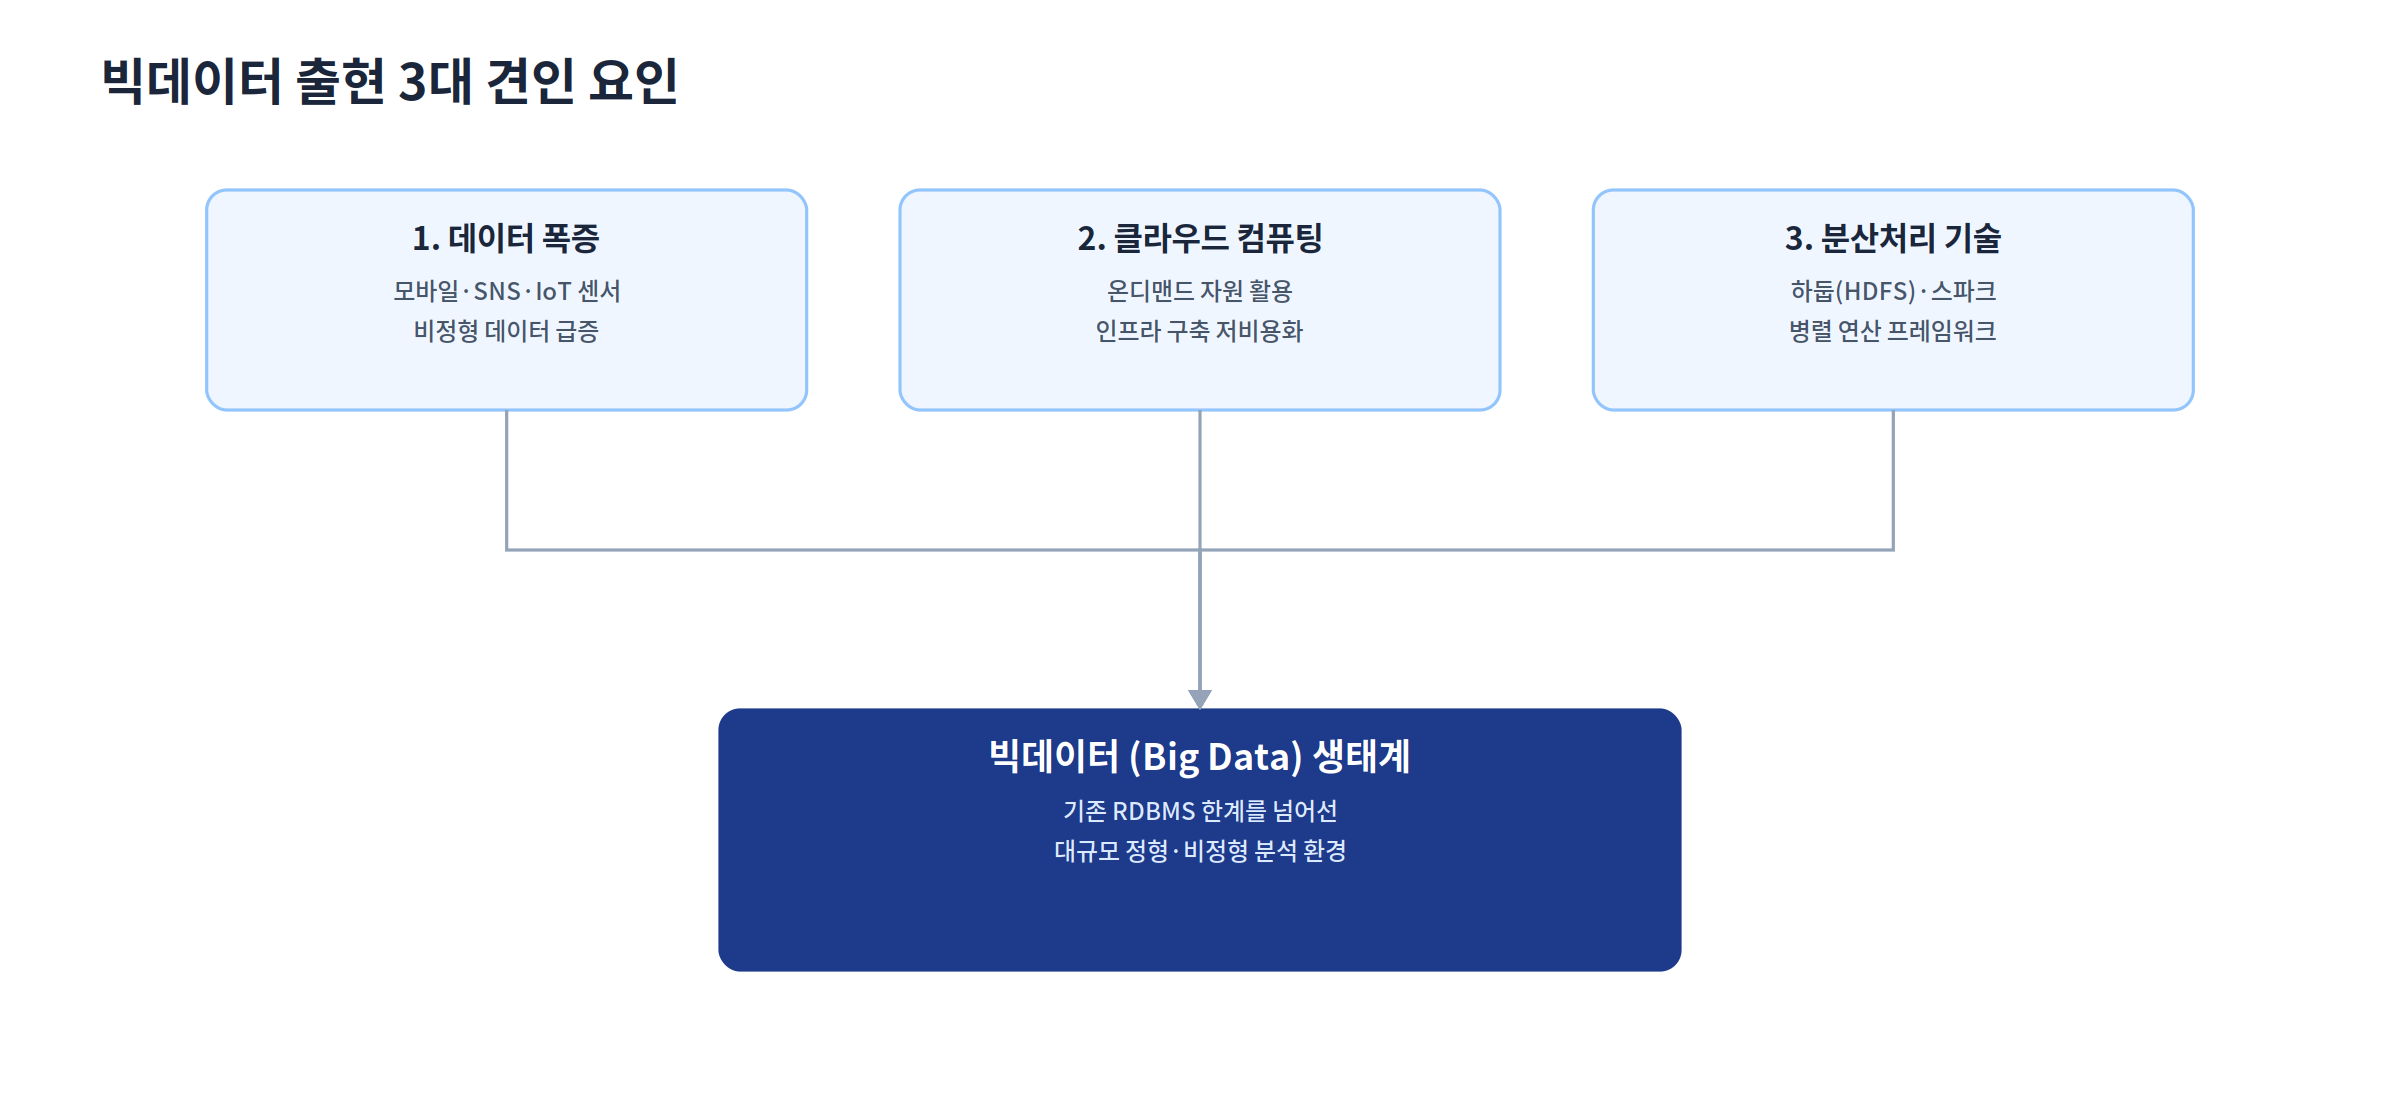
빅데이터가 산업 전반의 핵심 자원으로 부상한 배경에는 데이터 발생량의 급증뿐만 아니라, 이를 경제적으로 수용할 수 있게 만든 기술적 도약이 존재합니다.
| 출현 배경 요인 | 핵심 메커니즘 및 역할 | 제련 공장 비유 |
|---|---|---|
| 클라우드 컴퓨팅 (Cloud Computing) | 필요한 시점에 전산 자원을 즉시 할당받고 반납하는 온디맨드(On-Demand) 방식으로 인프라 구축 비용을 획기적으로 절감 | 대규모 원자재가 몰릴 때만 인근 제련 설비 라인을 유연하게 임대해 가동하는 ‘공유형 설비 렌털망’ |
| 분산처리 기술 (Distributed Processing) | 대용량 데이터를 여러 대의 서버에 쪼개어 분산 저장하고(HDFS), 동시에 병렬 처리(MapReduce, Spark)하는 분산 컴퓨팅 프레임워크 발전 | 하나의 거대한 용광로 대신 수백 대의 표준 제련기를 네트워크로 연결해 동시에 쇳물을 녹이는 ‘병렬 분산 용광로’ |
| 디지털 환경의 확산 (비정형 데이터 급증) | 인터넷, 스마트폰 모바일 기기, SNS, 사물인터넷(IoT) 센서 확산으로 텍스트·로그·영상 데이터 폭발 | 공장 센서, 운송 트럭 GPS, 작업자 음성 무전 등 실시간 현장 데이터의 24시간 연속 발생 |
참고: 하둡(Hadoop) 프레임워크란?
대용량 데이터를 저렴한 일반 서버 여러 대에 분산 저장하는 HDFS(Hadoop Distributed File System)와, 이를 병렬로 쪼개어 연산하는 맵리듀스(MapReduce) 소프트웨어 기술로 구성된 오픈소스 분산 처리 시스템입니다.
3. 대용량 데이터 단위 체계: PB부터 YB까지
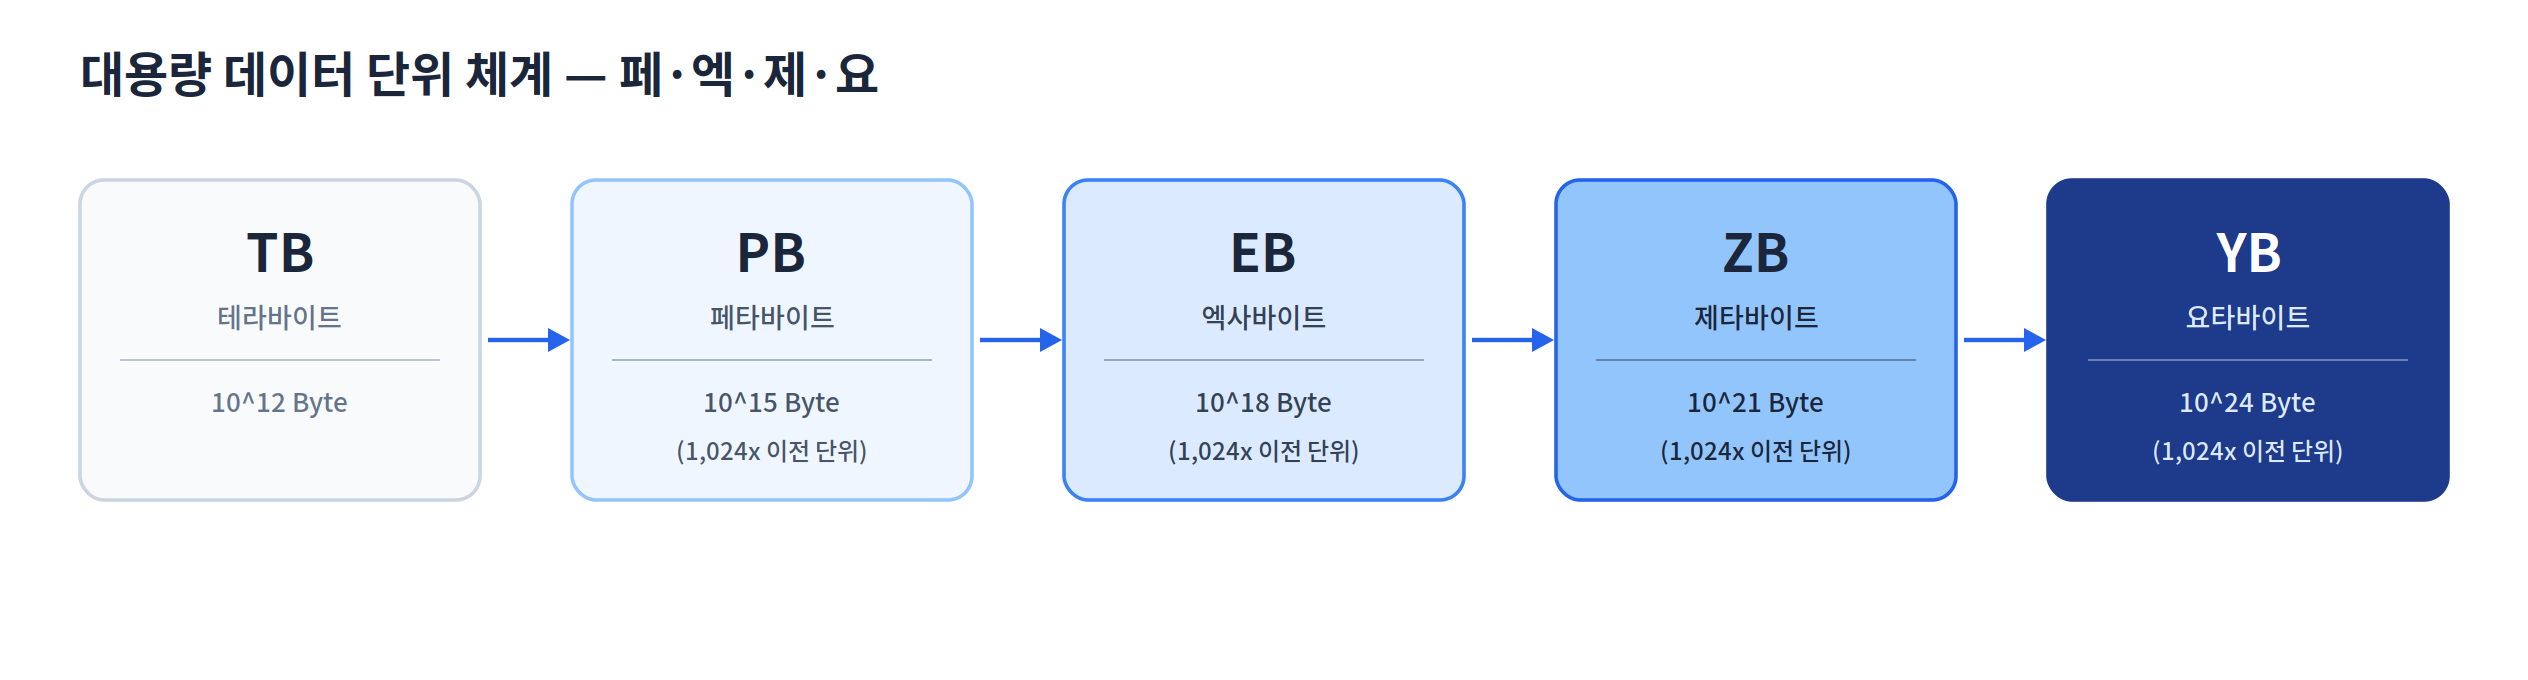
빅데이터 환경에서는 기가바이트(GB)나 테라바이트(TB) 수준을 넘어 훨씬 더 거대한 계량 단위를 사용합니다. ADsP 시험에서는 데이터 크기 단위의 작은 순서부터 큰 순서로의 배열을 정확히 숙지해야 합니다.
| 데이터 단위 | 풀네임 | 바이트 환산 크기 | 상대적 스케일 |
|---|---|---|---|
| PB | 페타바이트 (Petabyte) | 10^15 Byte (1,024 TB) | 빅데이터 분석의 기본 진입 단위 |
| EB | 엑사바이트 (Exabyte) | 10^18 Byte (1,024 PB) | 글로벌 인터넷 트래픽 집계 수준 |
| ZB | 제타바이트 (Zettabyte) | 10^21 Byte (1,024 EB) | 전 세계 1년간 생성되는 총 디지털 데이터 규모 |
| YB | 요타바이트 (Yottabyte) | 10^24 Byte (1,024 ZB) | 인류가 저장 가능한 초대형 데이터의 극한 단위 |
TB → PB → EB → ZB → YB
4. 데이터 산업의 5단계 발전 흐름
데이터를 다루는 산업의 패러다임은 단순한 시스템 내부 전산 처리에서 출발하여 개인의 권리를 보장하는 방향으로 진화해 왔습니다.
처리 시대 → 통합 시대 → 분석 시대 → 연결 시대 → 권리 시대
1. 처리 시대: 프로그래밍 언어(C, COBOL 등)를 기반으로 원시 데이터를 단순 입력·연산·출력하던 초기 단계 2. 통합 시대: 데이터 모델링과 관계형 데이터베이스(DBMS)를 도입해 사내 데이터를 체계적으로 통합·관리하던 단계 3. 분석 시대: 하둡, 머신러닝, 통계 알고리즘 등 빅데이터 기술을 활용해 인사이트를 도출하고 미래를 예측하던 단계 4. 연결 시대: API와 클라우드를 통해 서로 다른 기업·기관 간의 데이터 연계와 결합이 가속화된 단계 5. 권리 시대: 마이데이터(MyData) 도입 등 정보 주체인 개인이 자신의 데이터에 대한 열람·전송·통제권을 적극적으로 행사하는 단계
5. 빅데이터 출현을 이해하는 핵심 포인트
ADsP 수험생이 가장 많이 실수하는 대표적인 오답 패턴 두 가지를 정리합니다.
① “서버 CPU 속도 향상과 RDBMS의 발전이 핵심 원인이다?” (X)
단일 서버의 하드웨어 성능 향상(Scale-Up)이나 RDBMS의 안정성 강화는 빅데이터를 촉발한 핵심 요인이 아닙니다. 빅데이터 출현의 결정적 기술 요인은 ‘클라우드 컴퓨팅’의 온디맨드 자원 활용과 ‘하둡·스파크 같은 분산 병렬 처리 기술(Scale-Out)’의 발전입니다.
② “빅데이터는 주로 정형 데이터를 중앙집중형으로 저장한다?” (X)
빅데이터는 관계형 DB에 들어가기 힘든 로그, 텍스트, 이미지 등 비정형 데이터를 폭넓게 포함하며, 중앙집중 방식이 아닌 분산형 저장 및 처리 방식을 채택합니다.
6. 시험에서는 이렇게 출제됩니다
- 데이터 크기 순서 맞히기: PB, EB, ZB, YB의 순서를 뒤섞어 놓고 올바른 크기 순(작은 것 → 큰 것 또는 큰 것 → 작은 것)을 고르는 문제가 출제됩니다. 암기 팁은 앞 글자를 딴 ‘페·엑·제·요'(PB → EB → ZB → YB)입니다.
- 출현 배경 핵심 기술 고르기: 빅데이터 확산의 기술적 기반으로 ‘클라우드 컴퓨팅’과 ‘분산처리 기술’을 매칭할 수 있어야 합니다.
- 데이터 산업 발전 순서: 처리 → 통합 → 분석 → 연결 → 권리 흐름을 시대순으로 정렬하는 문제가 빈출됩니다.
7. 옆 개념과의 연결
빅데이터의 개념과 이를 가능하게 만든 인프라(클라우드·분산처리)를 이해했습니다. 이러한 방대한 데이터는 데이터의 규모·다양성·속도를 나타내는 3V/4V 특성을 가지며, 표본조사에서 전수조사로, 인과관계에서 상관관계로 패러다임을 바꿉니다. 이에 대한 상세 원리는 다음 편인 09편 빅데이터의 특징(3V·4V)과 패러다임 변화에서 이어집니다.
자주 묻는 질문(FAQ)
Q1. 페타바이트(PB)와 엑사바이트(EB) 중 어느 단위가 더 큰가요?
A. 엑사바이트(EB)가 더 큽니다. 1EB = 1,024PB이며, 전체 단위 순서는 PB → EB → ZB → YB 순으로 커집니다.
Q2. 빅데이터의 출현 요인에서 ‘온디맨드(On-Demand)’란 무엇인가요?
A. 사용자가 원하는 시점에 필요한 만큼 컴퓨팅 자원(서버, 스토리지 등)을 즉시 할당받아 사용하고, 사용이 끝나면 반납하여 비용을 최적화하는 방식을 의미합니다.
Q3. RDBMS로 빅데이터를 처리하는 데 한계가 있는 주된 이유는 무엇인가요?
A. RDBMS는 엄격한 테이블 스키마에 맞춰 정형 데이터를 다루는 데 최적화되어 있어, 소셜 미디어나 IoT 센서 등에서 쏟아지는 비정형·대용량 데이터를 유연하고 빠르게 분산 처리하기 어렵기 때문입니다.
마무리
08편에서는 초대형 제련 콤비나트 비유를 통해 빅데이터의 정의, 클라우드와 분산처리가 이끈 출현 배경, 대용량 계량 단위(PB·EB·ZB·YB), 그리고 데이터 산업 발전 5단계를 정리했습니다.
다음 09편에서는 빅데이터의 구조적 특징인 3V·4V와 분석 방법론의 4대 패러다임 전환을 다루는 빅데이터의 특징과 패러다임 변화로 이어가겠습니다.